¿Para qué sirve el aprendizaje por refuerzo en la IA de 2026?
Imagina a un cachorro aprendiendo a sentarse. No le das un manual de instrucciones detallado ni le explicas la física del movimiento; simplemente, cuando lo hace, recibe un premio. Si salta sobre el sofá, no recibe nada, o quizás un pequeño “no”. Esa es, en esencia, la lógica que mueve a una de las ramas más fascinantes de la inteligencia artificial actual. No se trata de decirle a una máquina qué hacer paso a paso, sino de enseñarle a descubrir qué hacer mediante la experiencia directa.
Para entender para qué sirve el aprendizaje por refuerzo, debemos alejarnos de la idea de “programar” y acercarnos a la de “entrenar”. En este paradigma, el software no recibe etiquetas de “correcto” o “incorrecto” de antemano. En su lugar, un agente autónomo se lanza a un entorno y comienza a interactuar con él. Cada acción genera una consecuencia, y esa consecuencia se traduce en una recompensa o una penalización. Es el arte de aprender a través del ensayo y el error, una técnica que permite a las máquinas desarrollar estrategias complejas que ningún humano habría sido capaz de codificar manualmente línea a línea.
Es la capacidad de la máquina para gestionar secuencias de decisiones donde cada paso afecta al siguiente, permitiendo una visión a largo plazo que otros métodos de aprendizaje simplemente no alcanzan.
El mecanismo de la recompensa y el bucle de retroalimentación
Para comprender realmente para qué sirve el aprendizaje por refuerzo, hay que diseccionar sus piezas fundamentales. No es un proceso lineal, sino un bucle constante de retroalimentación que involucra cuatro elementos críticos. Primero, tenemos al Agente, que es el protagonista: el software o sistema que debe aprender a tomar decisiones. Luego está el Entorno, que es el mundo exterior, el contexto donde el agente opera y reacciona.
A estas dos piezas se suman las Acciones y la Recompensa. Cada vez que el agente realiza una acción dentro de su entorno, el sistema devuelve una señal. Si la acción acerca al agente a su objetivo, recibe una recompensa; si lo aleja, recibe una penalización. A través de miles (o millones) de iteraciones, el agente ajusta su comportamiento para aprender una “política” o policy. Esta política es, en términos sencillos, la estrategia maestra: la regla que le dice al agente qué acción ejecutar en cada situación específica para maximizar su éxito acumulado.
Lo que hace que este método sea tan potente es su capacidad de gratificación aplazada. A diferencia de otros algoritmos que buscan el beneficio inmediato, el aprendizaje por refuerzo puede “sacrificar” una recompensa pequeña ahora para obtener una recompensa mucho mayor en el futuro. Es la diferencia entre comerse un dulce hoy o ahorrar para un banquete mañana. Esta visión de largo plazo es lo que permite resolver problemas de decisión secuencial complejos, donde el estado actual del sistema depende directamente de la decisión tomada un paso atrás.
Diferencias clave con otros modelos de aprendizaje
A menudo se confunde el aprendizaje por refuerzo con otras ramas de la inteligencia artificial, pero las diferencias son abismales en cuanto a la metodología de entrenamiento. Para entender para qué sirve el aprendizaje por refuerzo, es vital saber qué NO es.
En el aprendizaje supervisado, la máquina es como un alumno con un profesor que le corrige cada ejercicio: se le dan datos etiquetados manualmente (por ejemplo, fotos de perros con la etiqueta “perro”). En el aprendizaje por refuerzo, no hay profesor dando respuestas directas; solo hay un sistema de puntuación. Por otro lado, el aprendizaje no supervisado busca patrones ocultos en datos independientes, sin importar el orden. El aprendizaje por refuerzo, en cambio, se basa en secuencias ordenadas de datos interdependientes: una tupla de estado-acción-recompensa donde cada movimiento cuenta.
    Tipo de Aprendizaje
    Fuente de Información
    Objetivo Principal
    Ejemplo Analógico


    Supervisado
    Datos etiquetados por humanos
    Clasificación o predicción
    Un alumno con un libro de ejercicios corregidos


    No Supervisado
    Datos sin etiquetas
    Encontrar patrones ocultos
    Agrupar objetos por similitud sin saber sus nombres


    **Por Refuerzo**
    Interacción con el entorno
    Toma de decisiones óptimas
    Un cachorro aprendiendo trucos mediante premios
El modelo matemático: Procesos de Decisión de Markov
Aunque para el usuario común el concepto de “ensayo y error” es suficiente, en el trasfondo computacional y la teoría de juegos, este proceso se formula con precisión matemática. La relación entre el agente y su entorno se modela como un Proceso de Decisión de Markov (MDP). ¿Qué significa esto en la práctica? Significa que el sistema asume que el estado futuro depende únicamente del estado actual y de la acción ejecutada, permitiendo que la IA calcule probabilidades de éxito en intervalos de tiempo discretos.
Esta estructura matemática es la que permite que el agente “navegue” por diferentes estados. Cada vez que el agente actúa, el mundo cambia, y el agente debe evaluar su nueva posición. Es esta capacidad de modelar el mundo como una serie de estados interconectados lo que permite aplicaciones en áreas donde la planificación es vital, como la logística o la gestión de carteras de inversión, donde una decisión hoy determina las opciones disponibles mañana.
Aplicaciones prácticas en la robótica y la industria
Si nos preguntamos para qué sirve el aprendizaje por refuerzo en el mundo real, la robótica es quizás el escaparate más impresionante. Aquí, el aprendizaje por refuerzo permite que los robots aprendan movimientos finos y complejos que serían imposibles de programar manualmente. En lugar de escribir código para cada milímetro de movimiento de un brazo robótico, los ingenieros definen una recompensa por alcanzar un objetivo (por ejemplo, colocar una pieza en una línea de montaje) y el robot “descubre” la trayectoria más eficiente.
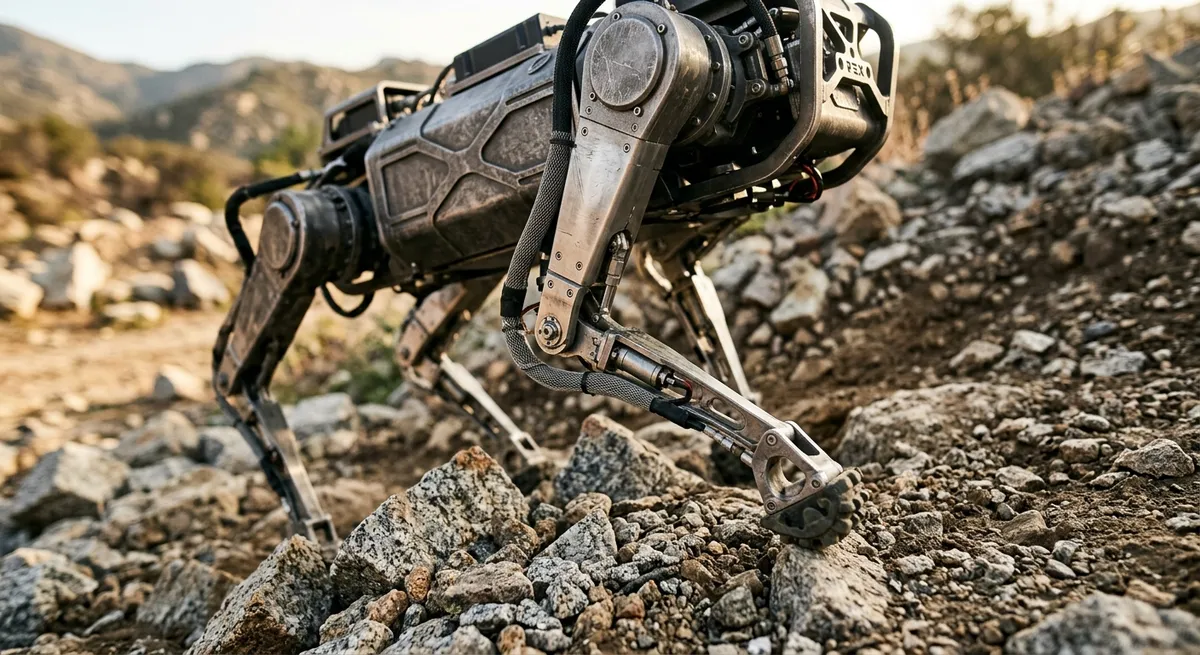
Ya se está utilizando en varios lugares, mucho en robótica, para mejorar la locomoción y el control de movimientos delicados. Esto incluye desde robots que aprenden a caminar sobre terrenos irregulares hasta sistemas que manipulan objetos frágiles sin romperlos. La capacidad de adaptación es la clave: si el peso del objeto cambia o el suelo se vuelve resbaladizo, el agente de aprendizaje por refuerzo puede ajustar su “política” para mantener el éxito de la tarea.
«Ya se está utilizando en varios lugares, mucho en robótica» Andrew Barto, investigador pionero galardonado con el Premio Turing
Barto, una figura clave en este campo, subraya que la utilidad práctica ya es una realidad tangible. No es una teoría abstracta; es la tecnología que permite que las máquinas interactúen con el mundo físico de manera más fluida y autónoma.
Vehículos autónomos y optimización financiera
Otro campo donde para qué sirve el aprendizaje por refuerzo se vuelve crítico es en la conducción autónoma. Un coche que circula por una ciudad no solo debe reconocer objetos; debe tomar decisiones en tiempo real: ¿cuándo cambiar de carril?, ¿cuánta distancia mantener con el vehículo de adelante?, ¿cómo reaccionar ante un peatón inesperado? El aprendizaje por refuerzo permite al vehículo evaluar estas decisiones en un entorno dinámico, donde las recompensas están ligadas a la seguridad, la fluidez y la eficiencia del trayecto.
En el ámbito de las finanzas, la aplicación es igualmente potente pero mucho menos visible para el público general. Se utiliza para la optimización de decisiones financieras y la gestión de carteras de inversión. En este contexto, el “entorno” es el mercado bursátil, las “acciones” son las compras o ventas de activos, y la “recompensa” es el retorno de la inversión. Los algoritmos pueden aprender a navegar por la volatilidad del mercado, identificando estrategias que maximicen el beneficio a largo plazo, incluso si eso implica aceptar pequeñas pérdidas temporales para evitar colapsos mayores.
Videojuegos y la superación de niveles de maestría
Es difícil hablar de este tema sin mencionar los videojuegos. El aprendizaje por refuerzo ha sido utilizado para entrenar agentes en juegos de estrategia y acción de alta complejidad. Estos sistemas no solo juegan mejor que un humano promedio; a menudo, desarrollan tácticas que los propios jugadores no habrían considerado. Al jugar contra sí mismos millones de veces, los agentes exploran una cantidad de posibilidades que sobrepasa la capacidad humana de procesamiento.
En juegos como el ajedrez, o títulos más modernos y complejos como StarCraft o Dota 2, el aprendizaje por refuerzo permite al software entender la importancia de las jugadas de apertura, la gestión de recursos y la planificación de ataques finales. El sistema aprende a ganar no porque se le haya dicho cómo ganar, sino porque ha descubierto que ciertas secuencias de acciones conducen con mayor frecuencia a la victoria.
El papel crucial del RLHF en la IA generativa
Quizás la aplicación más comentada en la actualidad es el aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF, por sus siglas en inglés). Si te preguntas para qué sirve el aprendizaje por refuerzo en modelos como los que generan texto o imágenes, la respuesta es la alineación. Los modelos de lenguaje de gran tamaño (LLM) pueden ser muy inteligentes, pero a veces pueden ser erráticos, ofensivos o simplemente no seguir las instrucciones del usuario.
El RLHF es la técnica que soluciona esto. En lugar de depender únicamente de recompensas matemáticas programadas por ingenieros, se introducen preferencias humanas directas en la función de recompensa. Los humanos evalúan las respuestas del modelo y “premien” aquellas que son útiles, precisas y seguras. Esto ayuda a que la IA se alinee con los valores y necesidades humanas, permitiendo que modelos como la familia Gemini puedan seguir instrucciones complejas de manera coherente.
Es una capa de refinamiento esencial. Mientras que el pre-entrenamiento da a la máquina el conocimiento general, el RLHF le enseña a comportarse de la manera que los humanos esperamos. Es, en esencia, una escuela de modales para la inteligencia artificial.
Diferencias de enfoque: ¿Tecnología o Pedagogía?
Es interesante observar que no todos ven el aprendizaje por refuerzo de la misma manera. Existe una discrepancia notable entre cómo lo aborda el sector tecnológico y cómo lo estudia la academia pedagógica. Mientras que gigantes como Microsoft, Google o AWS lo tratan estrictamente como un algoritmo de optimización de políticas en sistemas de Machine Learning, otras instituciones, como la Universidad Internacional de La Rioja (UNIR), lo analizan desde la psicología educativa.
Desde la perspectiva pedagógica, el aprendizaje por refuerzo se conecta directamente con el condicionamiento operante de B. F. Skinner. Aquí, el foco no es un “agente autónomo” en un servidor, sino el uso de refuerzos positivos y negativos en el aula para moldear el comportamiento de los alumnos. Es curioso cómo un mismo concepto —aprender mediante consecuencias— puede servir tanto para que un robot aprenda a caminar como para que un niño aprenda a concentrarse en clase. Aunque las herramientas son distintas, el principio de “recompensa” sigue siendo el eje central.
En el ámbito tecnológico, además, hay matices sobre la fuente de esa recompensa. Algunas plataformas distinguen claramente entre el “aprendizaje por refuerzo tradicional” (donde la recompensa es puramente algorítmica) y técnicas modernas como el RLHF, donde la retroalimentación humana es el componente principal. Esta distinción es vital para entender cómo se construye la IA que usamos hoy en día.
Desafíos y el equilibrio de la exploración
No todo es sencillo en el mundo del aprendizaje por refuerzo. Uno de los mayores retos, y que a menudo se pierde en las explicaciones simplistas, es el dilema entre la exploración y la explotación. Para que un agente aprenda de verdad, debe ser capaz de explorar el entorno, lo que significa que debe estar dispuesto a probar acciones que podrían dar resultados mediocres o incluso malos a corto plazo. Si el agente solo “explota” lo que ya sabe que funciona, nunca descubrirá una estrategia mejor o una ruta más eficiente.
Encontrar ese equilibrio es una de las tareas más complejas de la ingeniería de IA. Un agente que explore demasiado puede perderse en acciones sin sentido; uno que no explore lo suficiente se quedará estancado en una solución mediocre. Es un baile constante entre la curiosidad y la eficiencia, algo que imita de forma sorprendente la propia curiosidad humana.
A pesar de estos retos, la utilidad del aprendizaje por refuerzo sigue expandiéndose. Desde la optimización de tratamientos médicos secuenciales a lo largo del tiempo hasta la mejora de sistemas de recomendación, la capacidad de una máquina para aprender de sus propias acciones y ajustar su estrategia en función de resultados futuros es una de las herramientas más potentes de nuestra era tecnológica.
Quizá también te interese:
Fuentes consultadas
- ibm.com
- wikipedia.org
- github.io
- bbvaaifactory.com
- microsoft.com
- unir.net
- turingpost.com
Este artículo se ha elaborado con asistencia de inteligencia artificial a partir de las fuentes citadas, y ha pasado una verificación automática de datos antes de su publicación. La selección del tema y la decisión de publicarlo son editoriales.