¿Qué es la visión por computador? Guía completa para 2026
Imagina por un segundo que intentas explicarle a un ordenador qué es un gato. No puedes simplemente decirle “es un animal con bigotes”; tienes que enseñarle miles de imágenes, píxeles y sombras hasta que el software sea capaz de identificar esa silueta entre un millón de posibilidades. Esa es la esencia de la tecnología que está transformando nuestra realidad actual: la capacidad de las máquinas para “ver” y, sobre todo, para entender lo que están viendo.
La visión por computador es, en términos sencillos, la rama de la inteligencia artificial que permite a las máquinas adquirir, procesar y analizar información visual. No se trata solo de captar una imagen —eso lo hace cualquier cámara moderna—, sino de interpretar esa información para extraer datos significativos. Es el puente entre los datos binarios y la percepción del mundo real, permitiendo que un sistema tome decisiones basadas en lo que “ve” a través de una lente o un sensor.
En este artículo vamos a desgranar qué es la visión por computador, cómo se diferencia de la simple captura de datos y por qué se ha convertido en la columna vertebral de innovaciones que antes parecían ciencia ficción. Desde el diagnóstico médico hasta la navegación de vehículos sin conductor, esta tecnología está redefiniendo los límites de lo que una máquina puede hacer por nosotros.
Definiciones y matices: ¿Cómo se clasifica esta disciplina?
A veces, en el mundo de la tecnología, no hay un consenso unánime sobre dónde poner el dedo en el mapa. Dependiendo de a quién le preguntes, la visión por computador puede ser una cosa o otra. Por ejemplo, mientras algunas grandes tecnológicas la sitúan directamente como un subcampo de la inteligencia artificial (IA), otras fuentes prefieren verla como un campo de estudio dentro de la informática de manera más amplia, estrechamente relacionado con la IA pero con sus propias raíces académicas.
Es curioso, pero incluso la definición académica puede variar. Algunos la ven como una disciplina científica interdisciplinar que mezcla geometría, estadística y física con la informática. Básicamente, es una “navaja suiza” tecnológica. No podemos decir con total certeza una sola etiqueta, pero lo que sí es unánime es su propósito: emular la visión humana y la capacidad cognitiva necesaria para extraer información del mundo real y actuar en consecuencia.
Para entender mejor estas posturas, veamos cómo la definen algunas de las entidades más relevantes del sector:
  Entidad / Fuente
  Enfoque de la definición


  IBM
  Subcampo de la IA que dota a las máquinas de capacidad de procesamiento e interpretación visual.


  Wikipedia
  Disciplina científica interdisciplinar (geometría, estadística, física, informática).


  Databricks
  Campo de estudio dentro de la informática centrado en la comprensión visual fiel a la humana.


  Unity
  Campo de la IA que permite interpretar información visual para realidad aumentada y vehículos autónomos.
Sea como sea, la meta es la misma: que el software reconozca objetos, personas y entornos. Si una máquina puede distinguir una señal de stop de un árbol, o identificar una anomalía en una pieza de fábrica, la visión por computador está haciendo su trabajo.
El motor interno: Machine Learning y Deep Learning
¿Cómo hace un ordenador para “entender” una imagen? No es magia, es matemáticas puras aplicadas a gran escala. La base de esta tecnología reside en el uso de algoritmos de aprendizaje automático (Machine Learning) y, más específicamente, en el aprendizaje profundo (Deep Learning). Aquí es donde entran en juego las redes neuronales, estructuras diseñadas para imitar, de forma muy abstracta, la forma en que nuestras neuronas procesan la información.
En lugar de programar reglas fijas (como “si tiene orejas puntiagudas, es un gato”), los desarrolladores entrenan al modelo con una cantidad masiva de datos. El sistema aprende a identificar patrones: texturas, bordes, contrastes y formas. Es un proceso de ensayo y error a una velocidad vertiginosa. El modelo analiza miles de fotos y ajusta sus parámetros internos hasta que su tasa de acierto es lo suficientemente alta para ser útil en el mundo real.
Este enfoque permite que la visión por computador sea flexible. Un mismo modelo básico puede ser “reentrenado” para identificar células cancerígenas en una placa de Petri o para detectar grietas en una estructura de hormigón. La capacidad de generalizar es lo que diferencia a la visión por computador moderna de los antiguos sistemas de procesamiento de imágenes, que eran mucho más rígidos y propensos a fallar ante el más mínimo cambio de luz o ángulo.
Tareas principales y capacidades del sistema
Cuando hablamos de visión por computador, no nos referimos a una sola función, sino a un abanico de tareas que cubren casi cualquier interacción visual. Dependiendo de la aplicación, el sistema puede estar realizando diferentes operaciones técnicas simultáneamente. No es lo mismo detectar que hay un coche en una calle que saber exactamente qué tipo de coche es y hacia dónde se mueve.
A continuación, detallamos las tareas fundamentales que estas herramientas pueden ejecutar:
-
Clasificación de imágenes: Determinar qué hay en una foto (ej. “¿Es esto un perro o un gato?”).
-
Detección de objetos: Identificar la ubicación exacta de uno o varios objetos dentro de un marco visual.
-
Reconocimiento facial: Analizar rasgos biométricos para identificar a una persona específica.
-
Reconocimiento óptico de caracteres (OCR): Convertir texto impreso o escrito a mano en datos digitales editables.
-
Seguimiento de movimiento: Rastrear la trayectoria de un objeto a través de una secuencia de imágenes o un vídeo.
-
Segmentación semántica: Clasificar cada píxel de una imagen en una categoría específica (útil para delimitar carreteras, aceras o edificios en mapas).
Cada una de estas tareas requiere un nivel de precisión distinto. Por ejemplo, en el reconocimiento facial, un error de un par de píxeles puede significar una identificación incorrecta, mientras que en la clasificación de imágenes, un margen de error ligeramente mayor puede ser aceptable.
El proceso de desarrollo: De la captura al modelo entrenado
Construir una herramienta de visión por computador no es simplemente “conectar una cámara”. Es un proceso estructurado que requiere una planificación meticulosa. Si el proceso falla en una etapa temprana, el resultado final será, por decir lo menos, decepcionante. Por eso, el flujo de trabajo suele dividirse en etapas críticas que garantizan que el modelo sea robusto y fiable.
Primero está la captura de imágenes o datos. Aquí es donde se decide qué tipo de sensores se usarán y en qué condiciones ambientales operará el sistema. ¿Habrá mucha luz? ¿Habrá nieve? ¿La cámara estará fija o en movimiento? Una vez que tenemos los datos, pasamos al preprocesamiento. Esta fase es vital: consiste en limpiar la información, ajustar el contraste, normalizar los colores y redimensionar las imágenes para que el modelo pueda procesarlas de manera uniforme. Es como preparar los ingredientes antes de cocinar; si la materia prima está sucia, el plato final no saldrá bien.
Posteriormente, se procede a la selección del modelo informático y, finalmente, a la etapa más costosa en términos de recursos: el entrenamiento. Durante esta fase, el modelo “estudia” los datos preprocesados. Es aquí donde se ajustan los pesos de las redes neuronales hasta que el sistema es capaz de realizar las tareas asignadas con la precisión deseada. Una vez entrenado, el modelo está listo para ser desplegado en su entorno de producción.
Aplicaciones prácticas: ¿Dónde vemos esta tecnología hoy?
A veces cuesta visualizar cómo estas líneas de código se traducen en beneficios tangibles, pero la realidad es que ya están en todas partes. La visión por computador es la tecnología que permite que los hospitales detecten patologías con mayor rapidez, que las fábricas produzcan piezas sin defectos y que los coches se desplacen por nuestras calles sin intervención humana constante.
En el ámbito de la salud, el diagnóstico por imagen es uno de los campos más prometedores. Los sistemas pueden analizar radiografías, resonancias magnéticas o tomografías para detectar anomalías que podrían pasar desapercibidas para el ojo humano debido a la fatiga o la sutileza de la lesión. Aquí, la visión por computador actúa como un segundo par de ojos, extremadamente preciso y capaz de procesar volúmenes de datos masivos en segundos.
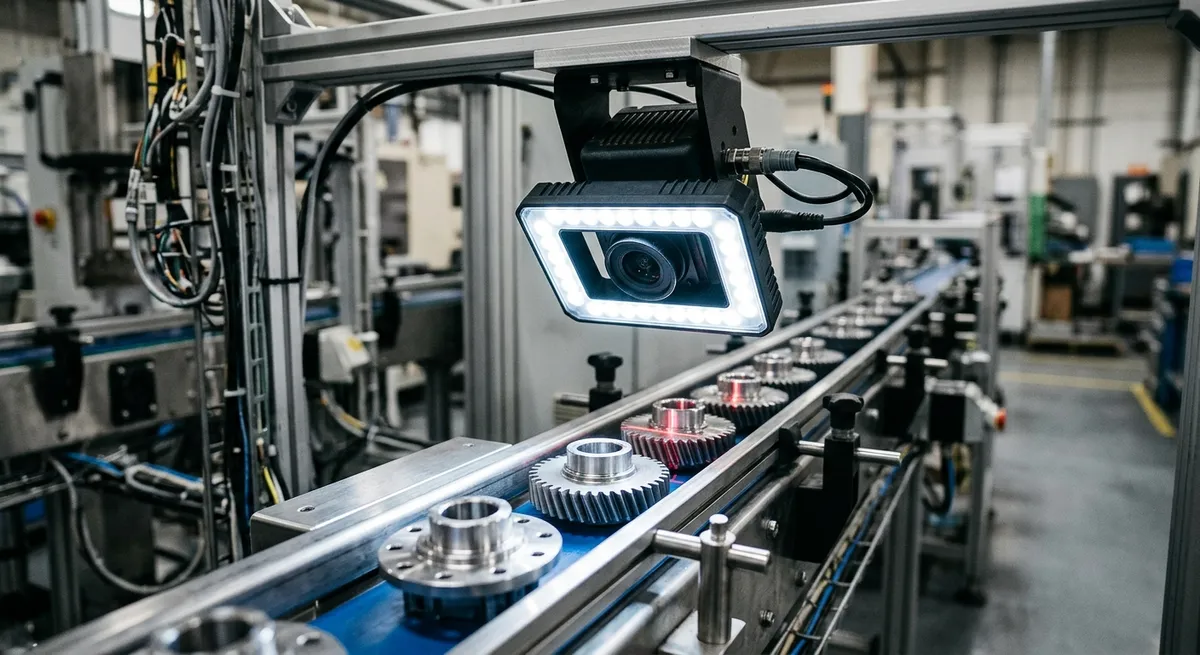
En la industria, la inspección de defectos en fabricación es un uso clásico pero esencial. Imagina una línea de montaje de componentes electrónicos; un sistema de visión puede verificar que cada pieza esté correctamente soldada en milisegundos, descartando automáticamente aquellas que no cumplan con los estándares de calidad. Esto reduce drásticamente los costes de error y mejora la seguridad del producto final.
Por otro lado, en el sector del comercio minorista y la seguridad, la tecnología permite el seguimiento de clientes, la gestión de inventarios en tiempo real y la monitorización de zonas de riesgo. La visión por computador permite entender el flujo de personas en una tienda o detectar comportamientos sospechosos en un edificio, todo ello analizando flujos de vídeo en tiempo real.
Principales sectores de aplicación de la visión por computador
  Sector
  Uso específico
  Beneficio principal


  Medicina
  Diagnóstico por imagen
  Detección temprana de patologías


  Automoción
  Vehículos autónomos
  Navegación y seguridad vial


  Manufactura
  Inspección de defectos
  Control de calidad automatizado


  Seguridad
  Monitorización de vídeo
  Detección de incidentes en tiempo real


  Retail
  Gestión de tiendas
  Optimización de la experiencia del cliente
Robótica y autonomía: El sentido del movimiento
Si hay un campo donde la visión por computador es absolutamente crítica, es en la robótica. Un robot sin visión es, en esencia, un autómata ciego que solo puede ejecutar movimientos preprogramados en un entorno controlado. Sin embargo, para que un robot sea verdaderamente autónomo, necesita “sentir” su entorno. Aquí es donde la integración de cámaras y sensores se vuelve fundamental.
En la robótica moderna, la visión por computador permite a las máquinas identificar la ubicación exacta de los objetos a su alrededor. Esto es vital para evitar colisiones. Imagina un robot de almacén que debe moverse entre estanterías y otros robots; gracias a la visión artificial, puede calcular distancias, identificar obstáculos móviles y ajustar su trayectoria en tiempo real. No es solo evitar un choque; es entender el contexto del espacio para moverse con fluidez.
Además, esta tecnología facilita la manipulación de objetos. Un brazo robótico puede identificar una pieza específica en una cinta transportadora, calcular su orientación y sujetarla con la fuerza y precisión necesarias. Sin la capacidad de interpretar la información visual, la robótica autónoma simplemente no daría la talla en entornos dinámicos y no estructurados como una fábrica o un almacén logístico.
Despliegue tecnológico: Nube, local o en el borde
Una de las preguntas que suele surgir es dónde “vive” realmente este software. La flexibilidad de la visión por computador es una de sus mayores virtudes, ya que puede desplegarse en diferentes infraestructuras dependiendo de las necesidades de latencia, potencia de cálculo y privacidad.
Por un lado, tenemos el despliegue en la nube (cloud). Es la opción ideal cuando se necesita procesar grandes volúmenes de datos y no se cuenta con hardware local potente. La nube permite escalar el procesamiento de forma casi infinita, lo cual es perfecto para aplicaciones de análisis de vídeo masivo o entrenamientos de modelos complejos. Sin embargo, esto introduce una dependencia de la conexión a internet y puede generar una latencia que no es aceptable en aplicaciones críticas.
En el otro extremo tenemos los dispositivos periféricos (edge devices). Aquí, el procesamiento se realiza directamente en la cámara, en un sensor o en un pequeño ordenador integrado en el dispositivo. Es la opción predilectiva para los vehículos autónomos o los drones, donde una demora de milisegundos en la interpretación de una imagen puede ser la diferencia entre un accidente y una maniobra segura. El procesamiento en el borde ofrece privacidad (los datos no salen del dispositivo) y una respuesta inmediata.
Finalmente, existen las instalaciones locales (on-premises). Muchas empresas, especialmente en sectores sensibles como la salud o la defensa, prefieren mantener sus sistemas en sus propios servidores. Esto garantiza el control total sobre los datos y permite aprovechar infraestructuras de hardware personalizadas para tareas de visión por computador de alta intensidad.
Citas de expertos y definiciones clave
Para terminar de asentar las bases de lo que estamos tratando, es útil acudir a las definiciones que han moldeado esta disciplina. Estas citas resumen perfectamente la esencia de la visión por computador y su papel dentro del ecosistema tecnológico actual.
«La visión artificial es un subcampo de la inteligencia artificial (IA) que dota a las máquinas con la capacidad de procesar, analizar e interpretar entradas visual como imágenes y vídeos.» IBM
Como bien señala IBM, la clave reside en la interpretación. No es solo captar la luz, es darle un significado a esa entrada visual para que la máquina pueda “entender” lo que está ocurriendo. «La visión por computadora se refiere a un campo de la inteligencia artificial que permite a las aplicaciones interpretar información visual del mundo digital, permitiendo que el software reconozca objetos, personas y entornos para su uso en realidad aumentada, vehículos autónomos e imágenes médicas.» Unity
Unity pone el foco en la utilidad práctica. La visión por computador no es un fin en sí mismo, sino una herramienta que habilita aplicaciones revolucionarias en sectores estratégicos como la medicina y el transporte. «La visión artificial es un campo de estudio dentro de la informática que se centra en permitir que las máquinas analicen y comprendan la información visual lo más fielmente posible a como lo hacen los seres humanos mediante el poder de la vista.» Databricks Esta última cita de Databricks subraya el objetivo último de la disciplina: la emulación de la percepción humana. Es la búsqueda de una visión “fiel” a la nuestra, una meta que sigue impulsando la investigación en redes neuronales y algoritmos de aprendizaje profundo.
¿Qué queda por descubrir en el horizonte de la visión por computador?
Aunque ya tenemos aplicaciones robustas y sistemas que funcionan con una precisión asombrosa, el campo de la visión por computador sigue siendo una frontera en constante expansión. Uno de los retos más fascinantes sigue siendo la comprensión del contexto profundo. Por ejemplo, una máquina puede identificar perfectamente un cuchillo y una mesa, pero entender la intención detrás de una acción —como alguien preparándose para cocinar o para algo más peligroso— requiere un nivel de razonamiento que aún estamos perfeccionando.
Además, la integración con otras formas de inteligencia artificial plantea interrogantes interesantes sobre cómo las máquinas combinarán lo que ven con lo que “saben” o lo que pueden “imaginar”. La capacidad de procesar información visual en tiempo real está dejando de ser una tecnología de nicho para convertirse en una capa invisible pero omnipresente en nuestra vida diaria. Cada vez que un teléfono desbloquea con tu cara, cada vez que un coche detecta un peatón o cada vez que un sistema de seguridad identifica un objeto extraño, estamos presenciando el éxito de la visión por computador.
Aún queda mucho camino por recorrer en términos de eficiencia energética y reducción de costes en el entrenamiento de modelos, pero la trayectoria es clara. La visión por computador no solo está cambiando cómo las máquinas ven el mundo; está cambiando cómo nosotros, a través de ellas, interactuamos con nuestra propia realidad.
Quizá también te interese:
Fuentes consultadas
- microsoft.com
- wikipedia.org
- ibm.com
- databricks.com
- stanford.edu
- unity.com
- intel.com
- hyperscience.ai
Este artículo se ha elaborado con asistencia de inteligencia artificial a partir de las fuentes citadas, y ha pasado una verificación automática de datos antes de su publicación. La selección del tema y la decisión de publicarlo son editoriales.